先确认来源与时间
一条资讯进入整理前,首先看是否来自公开发布、权威公告、当事方公开说明或可核对的正规媒体报道。若发布时间、转载链或上下文不完整,就明确标注“资料待补”,而不是用推测填空。这样的阅读顺序能把“看到什么”与“能确认什么”分开。
先看完这一记,再换下一场。 每日吃瓜把公开资讯拆成来源、语境、场景与后续四个阅读层次,先说明信息从哪里来、哪些内容仍需核对,再引导读者进入相关栏目。这里不追逐未经证实的传闻,也不以夸张数据制造热度,重点是让每一条可公开查阅的信息都有清楚的阅读位置。
同一段公开影像或图片,开场、静态环境、人物交流与收束往往承担不同信息。我们把画面中的可见事实、叙述者判断与外部补充区分开,提醒读者注意剪辑上下文、发布时间与来源说明,避免把局部片段直接当成完整结论。
查看啖面
不设虚假热度,不以排名决定阅读顺序。
一条资讯进入整理前,首先看是否来自公开发布、权威公告、当事方公开说明或可核对的正规媒体报道。若发布时间、转载链或上下文不完整,就明确标注“资料待补”,而不是用推测填空。这样的阅读顺序能把“看到什么”与“能确认什么”分开。
来源确认后,再补充必要的背景、名词解释与前后关系,并把可继续阅读的栏目放在文末。涉及人物时只采用可靠公开信息,不扩散私人联系方式、未公开行程或敏感个人资料;涉及作品时不复制完整内容,只说明公开信息与版权边界。
室内光线、窗口方向、街巷背景与环境声都能帮助理解画面,但这些线索只用于描述可见事实。我们不把模糊地点推断成精确地址,也不根据局部细节追踪个人位置。
阅读一段内容时,收场常常说明主题落点或信息边界。若后续仍缺少公开证据,会保留“待确认”状态,并把已知与未知分开写,让读者清楚哪些是原始信息,哪些只是编辑层面的阅读提醒。
主题归类按照城市生活、公共文化、创作观察、声音记录与轻松阅读等方向整理,每张说明卡只提供公开信息的阅读入口与范围说明。遇到争议话题时,不把未经证实的说法写成事实,也不会通过耸动标题扩大个人隐私或伤害。
适合需要先了解名词、时间顺序和公开出处的读者,强调资料核对与上下文。
适合从城市、声音和日常观察进入主题,不依赖猎奇或未经确认的个人信息。
集中收拢新出现的公开资料,先做来源核对和基本背景整理,不急于形成判断。
回看已整理内容,检查新增公开说明是否改变语境,并修正容易误读的表述。
保留仍需确认的问题,整理后续阅读入口与版权提醒,为下一阶段继续核对。
每日吃瓜APP页面用于介绍移动端的分类查找、主题阅读、内容进度与隐私设置。页面不会提供来路不明的安装包、破解版本或镜像地址,也不会要求用户通过充值、会员或虚构账户才能阅读基础说明。若需要安装,应先确认设备系统、来源可信度和应用权限,再决定是否继续。
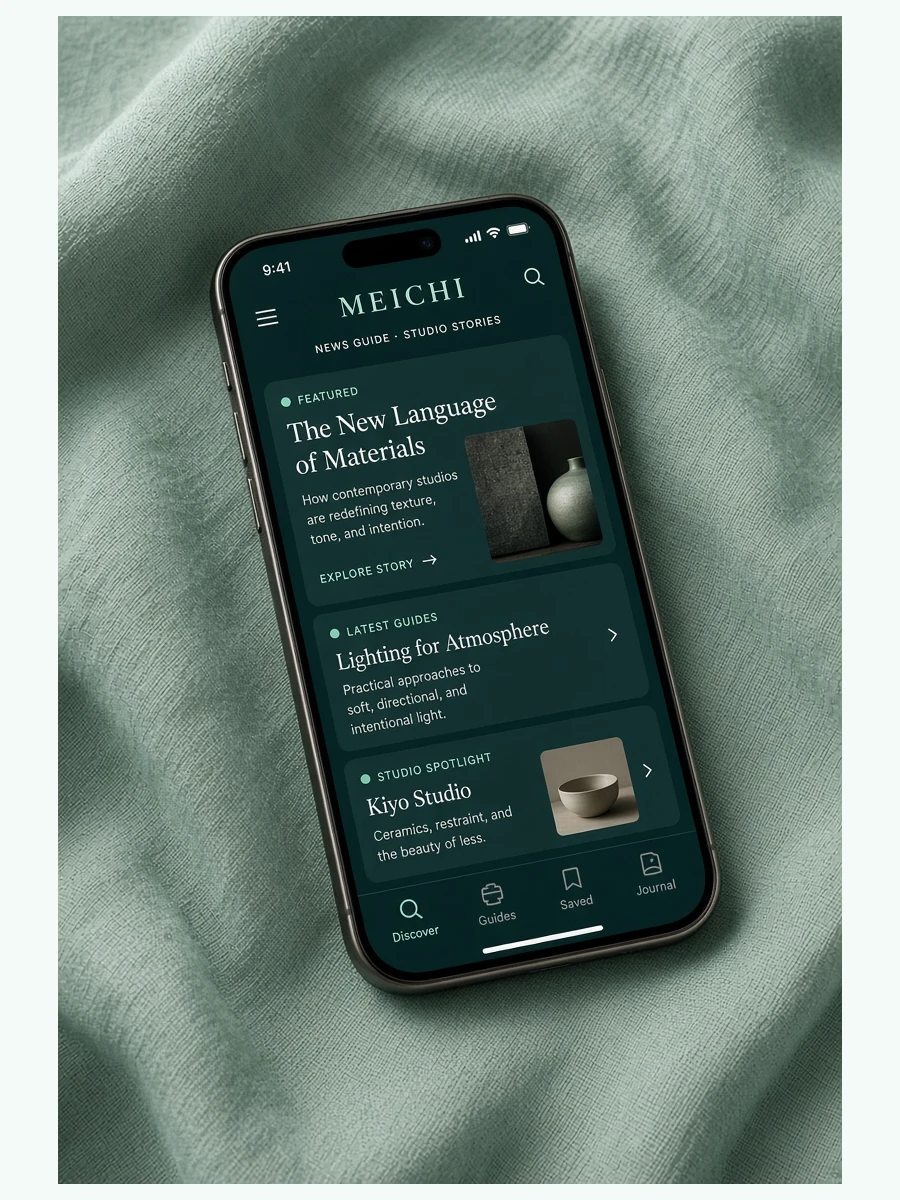
移动阅读设计强调“小屏也能完整看到正文”。栏目、版权说明和帮助内容不会因为设备不同而替换成另一套文本。隐私设置部分只解释可能涉及的基础访问数据与权限原则,不把不必要的通讯录、定位或相册权限包装成必需条件。
每日吃瓜希望“吃瓜”更接近一种轻松但有边界的阅读方式:可以关注公共话题和文化现象,但不应以伤害隐私、制造谣言或搬运侵权内容为代价。完整方法可进入看啖继续阅读。
不会。本站只做公开资讯导览、背景整理和版权说明,不提供未经授权的完整影像、网盘资源、破解包或镜像入口。涉及作品时,以合法公开资料为基础描述,不把外部盗版播放地址当作内容服务。
先看来源是否公开可核对,再看发布时间、上下文和当事方公开说明是否一致。若关键环节缺失,页面会保留待确认状态,而不是通过夸张标题或模糊措辞制造确定感。
因为本站定位是资讯导览,不掌握也不模拟第三方平台的真实播放数据。用虚构数字会让阅读顺序被“看起来很热门”左右,因此只依据主题、来源完整度和阅读价值组织内容。
不会主动收集或展示私人联系方式、精确住址、未公开行程等敏感资料。涉及真实人物时,仅使用与公共话题有关且来源可靠的公开信息,并在必要时说明信息边界。
核心正文一致。响应式设计只调整排版、导航位置与图片槽尺寸,不按设备隐藏或替换信息,也不会用浏览器类型把用户跳转到另一套内容页面。
可通过联系我们页面查看资料更正的提交要点。反馈时建议说明具体页面、需要更正的段落、公开依据和可核对来源,便于编辑判断是否需要修订或补充说明。
每日吃瓜不是“谁更夸张谁排前面”的信息列表,而是把公开话题拆成来源、场景、背景和后续四个层次。我们希望用户在轻松浏览时仍能看见资料边界:哪些来自公开发布,哪些是编辑整理,哪些仍等待更多信息。内容会优先避免未经证实的私人爆料、侵权搬运和诱导性跳转,并持续完善版权、隐私与更正机制。
了解每日吃瓜